广州8卡集群算力租赁 大模型训练与推理全流程解决方案
随着人工智能技术的快速发展,大模型已成为推动行业创新的核心引擎。大模型的训练与推理对算力提出了极高要求,自建GPU集群不仅成本高昂,还面临运维复杂、迭代缓慢等挑战。广州8卡集群算力租赁服务应运而生,为企业和研究机构提供了一套高效、灵活、低成本的全流程解决方案。
一、为什么选择8卡集群?
8卡GPU服务器(如NVIDIA A100/H100 80GB)是当前大模型训练的主流配置。其优势在于:
- 高显存容量:单卡80GB显存,8卡合计640GB,可支持百亿至千亿参数模型的训练与微调。
- 高速互联:通过NVLink和NVSwitch实现卡间高速通信,带宽高达600GB/s,显著加速分布式训练。
- 弹性扩展:多台8卡节点可通过RoCE或InfiniBand组网,线性扩展至千卡集群,满足超大规模训练需求。
二、广州算力租赁的核心优势
广州作为粤港澳大湾区的核心城市,在算力租赁领域具备独特优势:
- 区位与网络:广州拥有丰富的网络骨干资源,到全国主要城市的延迟低于30ms,便于实时推理业务部署。
- 成本优势:相比自建机房,租赁模式可节省高达60%的前期投入,且无需承担设备折旧和运维人力成本。
- 专业运维:本地服务商提供7x24小时技术支持和故障响应,确保集群可用性达99.9%以上。
- 合规与安全:广州数据中心符合国家等保要求,支持数据隔离和私有化部署,保障模型与数据安全。
三、全流程解决方案:从训练到推理
- 数据准备与预处理:提供高速存储(NVMe SSD)和并行文件系统,支持PB级数据吞吐,加速数据清洗与标注。
- 模型训练:基于8卡集群,结合Megatron-DeepSpeed、FSDP等分布式框架,实现数据并行、流水线并行和张量并行,训练效率提升3-5倍。
- 微调与对齐:支持LoRA、QLoRA等高效微调技术,在8卡上即可完成百亿模型的指令微调,大幅降低算力门槛。
- 推理部署:通过TensorRT-LLM、vLLM等推理引擎,结合动态批处理和量化技术,实现高吞吐、低延迟的在线服务。
- 监控与优化:提供GPU利用率、显存占用、网络带宽等实时监控,并借助自动化调优工具持续提升集群效率。
四、典型应用场景
- AI大模型创业公司:快速验证模型效果,缩短产品上市周期。
- 高校与科研院所:支撑自然语言处理、计算机视觉、多模态等前沿研究。
- 传统企业智能化转型:构建行业大模型,如金融风控、医学影像分析、智能制造等。
- AIGC内容生成:训练和部署文生图、文生视频模型,赋能创意产业。
五、如何选择广州算力租赁服务商
建议从以下维度评估:
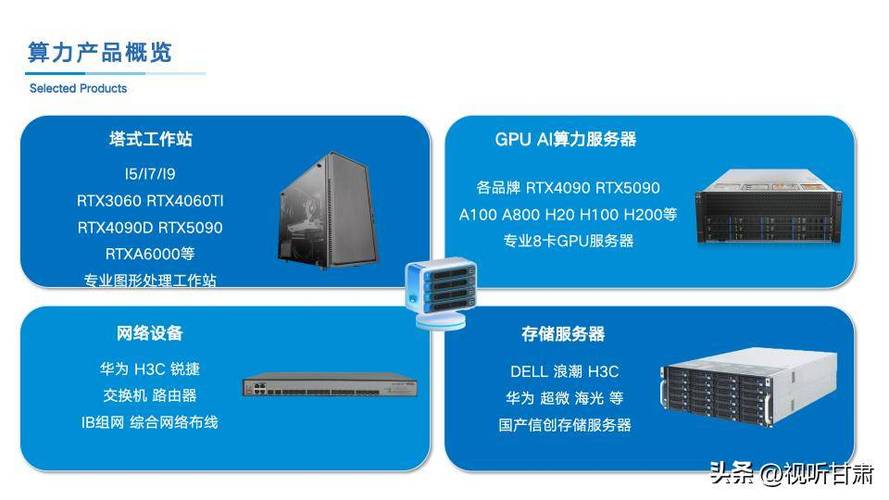
- 硬件配置:确认GPU型号(A100/H100/H800等)、显存、互联带宽和存储性能。
- 网络与扩展性:是否支持InfiniBand或RoCEv2,能否无缝扩展至多节点。
- 软件生态:是否预装PyTorch、TensorFlow、DeepSpeed等主流框架,并提供容器化环境。
- 计费模式:按小时、按天、按月或预留实例,根据任务周期选择最经济的方案。
- 技术支持:是否提供模型迁移、性能调优等增值服务。
###
广州8卡集群算力租赁为AI大模型训练与推理提供了“即插即用”的算力底座,让企业无需重资产投入即可获得顶尖计算资源。随着大湾区算力网络的完善,这一模式将成为推动AI普惠化的重要力量。立即咨询本地服务商,开启你的大模型之旅。
如若转载,请注明出处:http://www.gzhysjsb.com/product/13.html
更新时间:2026-10-15 16:23:07